大模型不再只是云端的“巨无霸”,如今也能在开发板端侧部署。触觉智能基于RK3576开发板(Purple Pi OH2),在6TOPS NPU算力上部署Qwen3.5-8B大模型,大家可以视频演示效果:
仅需数百行 Python 代码,即可将 LLM 推理与网页聊天界面完整跑在边缘端。今天,我们不谈概念,直接拆源码、看实测、讲工程,带你从零看懂一个能在浏览器里对话的本地大模型是如何炼成的。
源码路径:examples/rkllm_server_demo/rkllm_server/gradio_server.py
gradio_server.py是干嘛的?
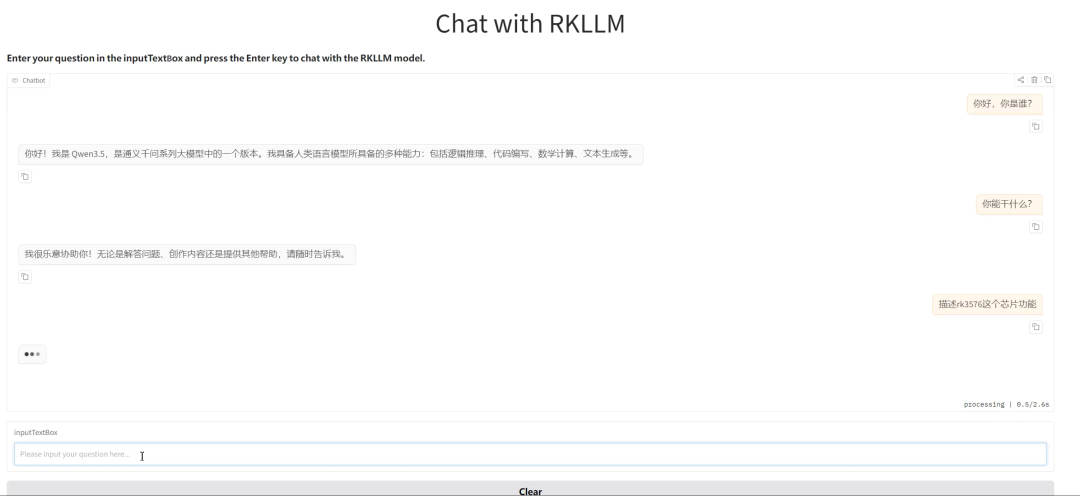
在rkllm_server_demo/rkllm_server/目录下,有一个gradio_server.py的工程文件。它做了一件事:在RK3576等开发板上,把RKLLM推理服务包装成一个浏览器可访问的聊天网页。
启动后访问开发板IP的8080端口,就能看到像ChatGPT一样的对话框:
•底部输入框提问
•上方展示多轮对话历史
•模型回答逐字流式输出,而不是一次全给
而这一切背后,没有云服务器、没有GPU,就通过触觉智能RK3576开发板内置的NPU进行工作。
整个程序可以拆成五层:
┌─────────────────────────────────────────┐ │ ⑤ Gradio Web 界面(聊天 UI + 事件链) │ ├─────────────────────────────────────────┤ │ ④ 流式输出机制(回调 + 线程 + 生成器) │ ├─────────────────────────────────────────┤ │ ③ RKLLM 类封装(初始化/采样/推理/释放) │ ├─────────────────────────────────────────┤ │ ② ctypes 绑定层(把 C 结构体映射进 Python)│ ├─────────────────────────────────────────┤ │ ① librkllmrt.so(Rockchip 官方 C 运行时)│ └─────────────────────────────────────────┘
下面从下往上逐层拆解。

第一层:ctypes把C库"翻译"成Python
RKLLM的推理引擎是C/C++写的,编译产物是librkllmrt.so。Python不能直接调C库,所以文件开头用ctypes做"翻译":
rkllm_lib = ctypes.CDLL('lib/librkllmrt.so')
然后把C里的结构体、枚举、联合体一个个"画"出来。比如推理参数:
class RKLLMParam(ctypes.Structure): _fields_ = [ ("model_path", ctypes.c_char_p), # 模型路径 ("max_context_len", ctypes.c_int32), # 最大上下文 ("max_new_tokens", ctypes.c_int32), # 最大生成长度 ("top_k", ctypes.c_int32), ("top_p", ctypes.c_float), ("temperature", ctypes.c_float), ... ]
这一层虽然枯燥,但极其重要——字段顺序、类型、字节大小都必须和C头文件完全一致,错一个字段,程序就跑偏甚至崩溃。这也是ctypes调嵌入式库的代价。
文件里定义了近20个结构体,覆盖了:
•推理参数RKLLMParam(采样参数、上下文长度等)
•输入RKLLMInput(支持文本、Token、Embedding、图文多模态四种输入)
•回调RKLLMCallback(推理结果如何回传)
•输出RKLLMResult(文本、性能统计等)
第二层:RKLLM类,把SDK封装成三件套
再往上,一个RKLLM类把整个SDK的生命周期收拢成初始化→推理→释放三个操作。
- 初始化:默认参数 "直接能用"
模型加载前先填好一整套采样参数,这里直接给了开箱即用的默认值:
rkllm_param.max_context_len = 4096 rkllm_param.max_new_tokens = 4096 rkllm_param.top_k = 1 # 近乎贪心 rkllm_param.top_p = 0.9 rkllm_param.temperature = 0.8 rkllm_param.repeat_penalty = 1.1
还开启了embed_flash = 1,把模型权重嵌入到NPU的内存里,换取更低的读取延迟——这是嵌入式LLM推理很关键的优化。
- 按平台分配 CPU 大核
RK3576是大小核架构,代码里特意把推理绑到大核上:
if platform.lower() in ["rk3576", "rk3588"]: # 大核 4~7 rkllm_param.extend_param.enabled_cpus_mask = (1 << 4)|(1 << 5)|(1 << 6)|(1 << 7) else: # 小核 0~3 rkllm_param.extend_param.enabled_cpus_mask = (1 << 0)|(1 << 1)|(1 << 2)|(1 << 3)
为什么?LLM推理不只在NPU上跑,token化、采样、解码这些杂活还要靠CPU。让它们跑在A72大核上,吞吐能明显拉开差距。
- 可选的LoRA与Prompt Cache构造函数还
•lora_model_path:加载LoRA适配器,实现风格/领域的低成本微调
•prompt_cache_path:加载Prompt Cache,把重复的公共前缀预计算缓存,省下首token延迟
- 推理:单条prompt,干净利落
def run(self, prompt, sampling_params=None, max_new_tokens=None): rkllm_input = RKLLMInput() rkllm_input.role = "user".encode('utf-8') rkllm_input.input_type = RKLLMInputType.RKLLM_INPUT_PROMPT rkllm_input.prompt_input = ctypes.c_char_p(prompt.encode('utf-8')) self.rkllm_run(self.handle, ctypes.byref(rkllm_input), ctypes.byref(self.rkllm_infer_params), None)
这里还有个值得点赞的细节:每次推理用完临时指针后立刻置空(sampling_params = None、max_new_tokens = 0),防止悬垂指针——ctypes调C最容易在这上面翻车。
第三层(全篇重点):流式输出是怎么实现的?
这是整个文件最有含金量的部分。它用回调+线程+生成器三件套,在Python里复刻了LLM的"打字机"效果。
- 回调:C库每吐一个词,就塞进全局列表
def callback_impl(result, userdata, state): global global_text, global_state if state == LLMCallState.RKLLM_RUN_NORMAL: global_text += result.contents.text.decode('utf-8')
C库每生成一段文本,就触发一次这个Python回调,把结果追加进一个全局列表global_text。Python与C之间的桥梁,就靠这一个CFUNCTYPE声明的函数指针:
LLMResultCallback_type = ctypes.CFUNCTYPE( ctypes.c_int, ctypes.POINTER(RKLLMResult), ctypes.c_void_p, ctypes.c_int)
- 线程:推理放进后台,别卡死界面
model_thread = threading.Thread(target=rkllm_model.run, args=(user_content,)) model_thread.start()
模型推理是阻塞的(is_async = False),如果直接在主流程里调用,UI会全程转圈。于是推理被扔进一个后台线程,前台靠轮询收结果。
- 生成器:5ms轮询一次,边收边吐
get_RKLLM_output是一个生成器——Gradio对生成器的每次yield都会刷新一次界面:
while not model_thread_finished: while len(global_text) > 0: history[-1]["content"] += global_text.pop(0) # 取走一个片段 time.sleep(0.005) # 5ms 节奏 yield history # 刷新 UI model_thread.join(timeout=0.005) model_thread_finished = not model_thread.is_alive()
于是效果就是:后台线程不停生成,前台每5ms把新内容粘到消息里并刷新。打字机的幻觉就这么来了,而且yield让整个循环不占满CPU。
一句话总结流式三件套:C库回调塞数据→后台线程跑推理→前台生成器轮询刷新。这个模式可以复用到任何"阻塞式C库+网页流式UI"的组合里。
第四层:Gradio界面,几十行搭出聊天页
用Gradio的Blocks API,界面代码干净得像在写配置:
with gr.Blocks(title="Chat with RKLLM") as chatRKLLM: rkllmServer = gr.Chatbot(height=600) # 对话区 msg = gr.Textbox(label="inputTextBox") # 输入框 clear = gr.Button("Clear") # 清空按钮 # 回车提交 → 先追加用户消息,再流式生成回答 msg.submit(get_user_input, [msg, rkllmServer], [msg, rkllmServer], queue=False) \ .then(get_RKLLM_output, rkllmServer, rkllmServer) clear.click(lambda: None, None, rkllmServer, queue=False) chatRKLLM.queue() # 开启事件队列 chatRKLLM.launch() # 启动
- 两个细节值得记:
•queue=False:让第一次提交立即执行,不被Gradio队列排队,保证打字机节奏不卡顿。
•.then()事件链:先把用户消息拼进历史,再触发生成器逐步更新,两个阶段串成一条流水线。
另外输入解析做了新旧两代Chatbot格式兼容——既能处理老的[[user, assistant], ...]格式,也能处理新的[{"role": "user", "content": ...}]dict格式,还顺带兼容了多模态的content列表结构。可见官方在这套demo上维护得很用心。
主流程:从命令行到优雅退出
main里的几件事,处处体现"嵌入式工程经验":
1、参数校验:--rkllm_model_path和--target_platform必填,路径存在性和平台白名单(rk3588/rk3576/rv1126b/rk3562)都先查一遍,错就直接报错退出。
2、锁频脚本:启动前先跑一句
command = "sudo bash fix_freq_rk3576.sh".format(args.target_platform) subprocess.run(command, shell=True)
把CPU频率锁到最高。为什么?NPU推理时CPU承担解码等任务,如果频率被DVFS压下来,token生成速度会忽快忽慢,用户体验极其不稳。锁频是嵌入式推理的"必做功课"。
3、提高文件描述符上限:
resource.setrlimit(resource.RLIMIT_NOFILE, (102400, 102400))
大模型推理会打开大量文件/句柄,默认上限根本不够。
4、优雅退出:SIGINT/SIGTERM都注册了处理器,Ctrl+C时先release()释放NPU资源再退出,避免设备上残留占用的模型句柄。
启动与部署
用官方配套的构建脚本一条命令完成部署(推代码、装依赖、起服务):
./build_rkllm_server_gradio.sh \ --workshop /userdata \ --model_path /userdata/model.rkllm \ --platform rk3576 \ --adb_device <板子序列号>
脚本会自动:安装pip3和gradio →把librkllmrt.so、锁频脚本、服务代码推送到板子→在板端启动服务。启动后浏览器打开http:// <板子ip> :8080就能聊。
代码里还注释了一段Chat Template设置(set_chat_template),说明SDK原生支持自定义系统提示词与对话模板,只需解开注释按需改即可。
可以做得更好的地方
最后说说这个文件里我看到的几个可以改进的点:
1、多字节UTF‑8截断风险:回调里直接text.decode('utf-8'),如果C库某次吐出的片段恰好把一个汉字从中间截开,decode就会抛UnicodeDecodeError。代码里其实预留了split_byte_data全局变量,但没用上——安全做法是拼好字节后再统一解码。
2、全局变量传数据:global_text/global_state是模块级全局量,多用户并发时会产生竞态。示例是单用户场景,够用;若要服务多人,建议改成线程安全的队列或按会话隔离。
3、set_chat_template被注释:默认对话模板写死在系统提示词里,若要支持多模型(Qwen、Llama等),模板应该做成可配置。
结语
gradio_server.py的价值不在于它"炫技",而在于它把底层C库、ctypes绑定、多线程流式、Web UI这几层串成了一个能跑通的完整闭环。对于想在嵌入式板子上做LLM应用的朋友,它是一个非常值得反复读的样板:
•想学ctypes调C库?看结构体映射;
•想做流式输出?看回调+线程+生成器;
•想做边缘端AI部署?看锁频、文件描述符、资源释放这些工程细节。
Purple Pi OH2开发板,是触觉智能RK3576核心板SOM7609系列配套的评估开发板,搭载4核A72+4核A53+M0多核异构处理器,主频2.2GHz,集成6Tops NPU,轻松应对AI推理、边缘计算与轻量级AI端侧学习。配套完善SDK、丰富资料与Demo,有助于项目前期快速开发验证。
触觉智能SOM7609系列核心板尺寸仅仅40.5×40.5mm,专为空间受限场景打造。基于RK3576/RK3576J SoC,集成高性能GPU与VPU,支持4K视频编解码与多屏异显;提供PCIe、USB3.2、双路千兆以太网、MIPI-DSI/CSI、eDP、CAN、SPI、I2C等丰富接口,灵活扩展。支持Linux、Android、开源鸿蒙OpenHarmony等丰富系统,配套硬件设计指南、源码与技术支持,助力产品快速落地。