模型已可用 边缘正当时
导语
过去一年,AI行业最大的变化,不是某一个模型"更能打",而是越来越多的模型真正到达了"可用"阶段——能力经得起真实业务检验,成本低到用得起,部署门槛低到接得起。
而这批"可用"的模型,参数量并不夸张。以刚刚发布的DeepSeek V4 Flash和千问3.8 Flash为例,它们用同一个事实说话:好用,不需要"巨大"。当模型不再"巨大",边缘侧AI芯片的机会窗口就打开了。
一款真正适配可用模型的边缘侧AI芯片,将具备哪些关键要素?本系列内容,我们将用三篇文章,从模型侧到芯片端进行详细拆解介绍。
模型侧,正批量进入"可用阶段"
"可用"不是一个营销词,它有两个硬指标:
能力达标:在摘要、写作、问答、代码、Agent编排等真实任务上,达到可以直接交付的水平,而不是发布会上的demo;
部署可得:开源权重或低门槛API服务,让任何团队都能快速接入,接得起。
当这两个条件同时满足,行业的竞争焦点就会从"谁更能秀"转向"谁更好用"——厂商不再需要靠烧钱引流来为不成熟的技术补课,而是真刀真枪地拼产品体验与落地成本。
两个"刚刚发布"的例证:DeepSeek V4 Flash × 千问3.8 Flash
DeepSeek V4 Flash:284B总参的开源MoE
2026年4月,DeepSeek-V4预览版发布并开源,分Pro / Flash两档;
Flash档为284B总参数(MoE稀疏激活架构),主打高性价比与低延迟;
标配百万级上下文;
预训练数据量超过32万亿token,底座能力扎实;
2026年7月31日,V4-Flash-0731正式版发布,通过强化后训练进一步把"性价比"拉满。
千问3.8 Flash:6B激活的多模态MoE
2026年8月发布,通过千问AI平台提供API服务;
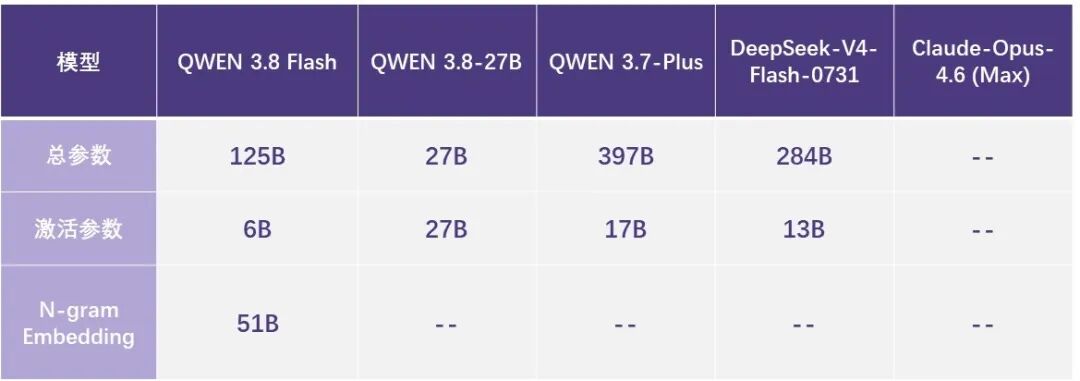
主模型125B参数 + 51B N-gram Embedding,每token仅激活6B参数;
架构亮点:GDN + QSA混合注意力、Gated Residual四分支残差、N-gram Embedding查表记忆、Muon优化器,并内置MTP模块提升投机解码接受率;
开源版(QWEN 3.8-Flash-Next)原生256K;
训练成本约为QWEN 3.7-Plus的1/9,编码与办公任务更强。
参数规模对比
核心跑分对比
小结这13项基准:在已公布数据的对比中,编码(SWE-bench Pro +9.1、LiveCodeBench v6 +3.1)、办公(JobBench +19.1、CoWorkBench +5.7)、指令遵循(IFBench +18.8)等维度优势明显;唯一落后的是综合推理HLE(35.9 vs 40.0)。考虑到QWEN 3.8 Flash每token仅激活6B参数,而 Opus 4.6参数规模未公布,这份成绩单说明:"总参数-激活参数分离"的新架构,正在用极小的激活成本逼近甚至超越更大规模的闭源模型——"好用不需要巨大"的判断,在这里有了实打实的数字支撑。
一个关键背景:这类大参数的MoE模型,普遍采用"总参数-激活参数分离"的设计——总参数量决定模型的知识容量(也决定内存容量需求),而每个token实际激活的参数只有一小部分(如V4 Flash的13B、QWEN 3.8-Flash的6B),决定推理时的算力与带宽需求。这正是它们能做到"又大又便宜又够快"的原因。
模型对比的新焦点:长任务完成度,而不是参数量
过去评价一个模型,习惯先看参数量:700B、1.6T、2.4T……参数量似乎成了能力的代名词。但真实业务早就不再是"问一句、答一句"的单轮问答,而是动辄几十分钟甚至几小时的长任务:
Agent编排:把一个大目标拆成多步行动,反复调用工具、观察结果、修正计划;
长文档处理:几十万token的合同、代码库、研究报告,一次读完还要跨章节引用;
办公长流程:从整理资料到产出方案/周报的完整链路,一步错步步错;
仓库级开发:在真实代码仓库上修bug、加功能,跑完整套测试才算交付。
这也解释了为什么新一代评测把重心放在长任务上——CoWorkBench、JobBench、SWE-bench、Toolathon、Agents' Last Exam等基准,测的都不是"会不会答",而是"能不能把事办完"。
回头重看跑分表:QWEN 3.8 Flash对Opus 4.6领先最多的,恰恰是JobBench(+19.1)、CoWorkBench(+5.7)、SWE-bench Pro(+9.1)这些长任务基准。一个6B激活参数的模型,在大模型最擅长的事情上反超,说明模型时代的竞争力已经转移:从"谁的参数多",变成了"谁把长任务完成得更好"。
长任务,给端侧部署带来的新挑战
模型变得"长任务友好",不等于端侧部署变容易。恰恰相反,长任务把部署的难度从"装得下"推到了"跑得动、跑得久、跑得稳":
长上下文吞噬内存:长任务必然长上下文。在deepseek V4 Flash的混合注意力(CSA/HCA)压缩下,1M上下文的KV cache约需4–7 GB(取决于精度),虽远低于Dense模型的同等量级,但是不是每个模型都像V4 Flash这样做极限压缩,内存不够,模型撑不到任务做完;
长时间持续运行:Agent任务可能连续运行数小时,decode速度直接决定总时长,而功耗与散热是边缘设备的物理约束;
多步交互的吞吐压力:每一步都要重读上下文、重新计算,总token吞吐是单轮问答的数倍到数十倍,对带宽是持续的考验;
稳定可靠:长任务最怕中途失败——OOM、过热降频、精度漂移,任何一次中断都意味着前面的工作全部白做。
所以,边缘侧AI芯片要承接长任务,光"能装下模型"只是入场券,真正的门槛是:内存够大,装得下长上下文;带宽够高,跑得动持续生成;功耗可控,撑得住长时间运行。
如何跨过这道门槛?面临的关卡都有哪些?为此边缘AI芯片需要具备哪些“品质”?我们将在下篇文章进行详细解读,敬请持续关注。