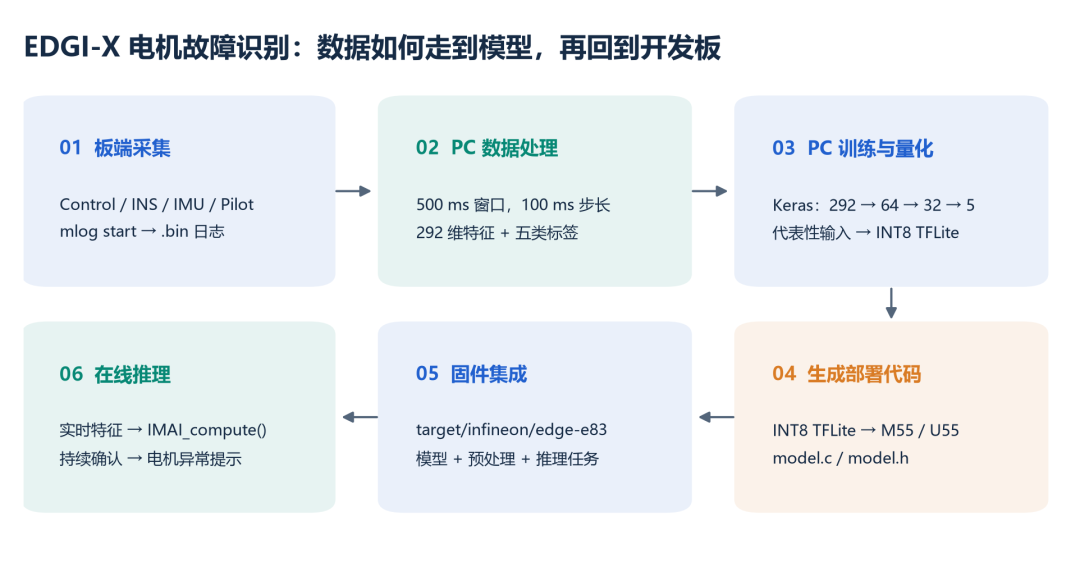
一段运行日志,怎样变成能在开发板上运行的模型?这篇文章沿着当前 FMT 工程,把采集、数据处理、模型训练、转换、烧录和在线推理逐步走一遍。目标是输入一段控制与运动数据,输出“正常”或“某一路电机异常”。
EDGI-X 负责记录运行数据和执行推理,PC 负责数据处理、训练与模型转换。本文使用项目已有的 TensorFlow/Keras 训练脚本,导出 motor_fault_mlp_int8.tflite,经 DEEPCRAFT Model Converter 生成 C 代码,集成到 FMT-Firmware/target/infineon/edge-e83 固件工程。数据来自仿真,1~4 号电机异常在仿真中触发。
目录 |
01 |
先准备工程、开发板和 PC 环境 |
02 |
在 EDGI-X 上采集什么,怎么采集? |
03 |
打开原始数据:一条日志长什么样? |
04 |
如何把连续信号处理成 292 维输入? |
05 |
怎样训练模型,训练得到什么? |
06 |
用 DEEPCRAFT Model Converter 将 TFLite 转成 C 代码 |
07 |
怎么放进 FMT 工程,怎么编译和烧录? |
08 |
上电后模型怎么跑,如何看到推理结果? |
09 |
配套文件 |
先准备工程、开发板和 PC 环境
本文用到的两个目录位于同一工作区:
FMT-Firmware_all/├── FMT-Firmware/│ ├── utils/python_mlog_parser/parse_mlog.py│ └── target/infineon/edge-e83/m55/│ ├── applications/ # 电机故障采集、特征与推理代码│ ├── SConstruct│ └── rtconfig.py└── FMT无人机电机训练/ ├── scripts/build_motor_fault_dataset.py ├── scripts/train_motor_fault_mlp.py ├── training_dataset_multiclass_balanced/ ├── model_training/ └── docs/article_code/prepare_conversion.py
开发板需已能启动当前 FMT 固件,SD 卡已挂载,控制输出、INS、IMU 与遥控器话题能正常更新。板端代码中的任务名称是 mf_model,模型运行在 M55 工程中。
PC 侧准备 Python、TensorFlow/Keras 和英飞凌 DEEPCRAFT Model Converter;固件侧使用 SCons 和 Arm GNU 工具链。使用的固件根目录为 C:\Users\RTT\Desktop\work\FMT-Firmware_all\FMT-Firmware\target\infineon\edge-e83。仓库中可核实的流程是 SCons 构建 HEX,再由 tools/m55_program.ps1 调用 OpenOCD 下载。
在 PC 的 PowerShell 中进入 FMT无人机电机训练,可用独立环境安装项目记录的依赖。已有训练环境可以直接复用:
condacreate -n edgix-ai python=3.10-ycondaactivate edgix-aipython-m pip install -r requirements-ml.txtpython-c"import tensorflow as tf; print(tf.__version__)"
依赖文件固定了项目使用的版本,其中 TensorFlow 为 2.15.1、Keras 为 2.15.0。本文后续 PC 数据与训练命令,除特别说明外,都在 FMT无人机电机训练 目录执行。
在 EDGI-X 上采集什么,怎么采集?
模型使用四组信号,既看控制器给出的指令,也看机体如何响应。
数据组 |
原始字段示例 |
用途 |
Control_Out |
actuator_cmd[0..3] |
四路电机 PWM 控制指令,观察输出差异与饱和情况 |
INS_Out |
phi/theta/psi、p/q/r、ax/ay/az、vn/ve/vd、h_AGL |
姿态、角速度、加速度、速度与高度 |
IMU |
gyr_x/y/z、acc_x/y/z |
原始惯性测量,观察快速运动变化 |
Pilot_Cmd |
stick_yaw/throttle/roll/pitch |
操作输入,帮助区分主动操纵与异常响应 |
连上控制台,先检查输入
当前默认配置中的串口控制台是 serial4,波特率 57600。使用与该串口对应的连接,串口终端设置为 57600、8N1。如果 SD 卡 /sys/sysconfig.toml 已覆盖默认设置,以板上配置为准。默认 USB 通道用于 MAVLink,直接打开 USB COM 口不一定会得到文本 Shell。
进入 FMT Shell 后,先看任务和话题,再读取少量数据:
tasklistmcnlistmcnecho control_output -n3mcnecho ins_output -n3mcnecho sensor_imu0 -n3mcnecho pilot_cmd -n3
这里需要确认话题有数据、时间戳在推进。电机控制值或运动数据长期不更新时,应先检查上游输入;模型只能处理实际送进来的数据。
开始记录一段场景
FMT 的 mlog 会将各消息写入二进制日志。为了按场景手动控制日志,可将当前会话的日志模式设为手动,然后开始记录:
paramgetSYSTEMMLOG_MODEparamsetSYSTEMMLOG_MODE0mlog stopmlogstartmlog status
mlog status 会显示当前日志文件名和统计信息。路径形式为 /log/session_N/mlogM.bin,其中会话号和文件编号以实际输出为准。
此时运行仿真场景,并在仿真中触发对应的 1~4 号电机异常。每条日志保留正常段和异常段,记录异常电机编号、发生时间与采集批次。后文直接使用项目保存的这些仿真日志。
场景结束后,再执行停止命令:
mlogstopmlog status
停止写入并关闭开发板电源后,取出 SD 卡,通过读卡器将对应 log/session_N/ 下的 .bin 文件复制到 PC。前面记录的 MLOG_MODE 如需恢复,可用 param set SYSTEM MLOG_MODE 原值 设置回来;上述示例没有执行参数持久化保存。
给新日志安排可识别的目录
现有数据集脚本会扫描以下新数据目录,并从父目录识别故障类别:
FMT无人机电机训练/└──extracted_20260622/电机异常日志-新/ ├──1号电机异常/采集批次01/mlog1.bin ├──2号电机异常/采集批次01/mlog1.bin ├──3号电机异常/采集批次01/mlog1.bin └──4号电机异常/采集批次01/mlog1.bin
这里的目录名标注的是日志中的异常类别。脚本还会根据控制输出估计异常起点,从日志前段提取正常窗口,从后段提取异常窗口。它不会把“1号电机异常”目录里的整段日志都标为异常。
打开原始数据:一条日志长什么样?
.bin 不适合直接阅读。先运行项目已有的解析器,在弹出的文件选择窗口中选择日志:
python ../FMT-Firmware/utils/python_mlog_parser/parse_mlog.py
以 mlog2.bin 为例,解析后会在旁边生成 mlog2_out:
mlog2.binmlog2_out/├── mlog2_report.txt├── mlog_msg_3_INS_Out.csv├── mlog_msg_11_IMU.csv├── mlog_msg_16_Pilot_Cmd.csv└── mlog_msg_17_Control_Out.csv
下面是项目“电机1失效”日志中的实际数据,只摘出四路有效 PWM 列:
timestamp,actuator_cmd[0],actuator_cmd[1],actuator_cmd[2],actuator_cmd[3]170700,1641,1355,1483,1495170800,1900,1190,1536,1653171200,1900,1100,1303,1502
时间戳单位为 ms。在 170800 ms 附近,1 号电机对应的控制指令升至 1900。PWM 表示飞控的输出指令,不能直接当作电机真实转速或推力;还要对照机体姿态变化。
IMU CSV 的结构不同,每行包含一个时间戳和六个惯性测量值。以下两行来自同一日志,数值为便于阅读做了小数位截取:
timestamp,gyr_x,gyr_y,gyr_z,acc_x,acc_y,acc_z,delta_ts123890,0.010182,-0.005279,-0.001336,0.078213,0.024667,-5.379662,0123892,0.006318,-0.009801,-0.000700,-0.002027,-0.044381,-13.514107,2
这份样例中,IMU 约 500 Hz,控制输出与 INS 约 10 Hz,遥控器数据则不等间隔。各张 CSV 的第 N 行通常不是同一时刻,不能按行号横向拼接。 后续按时间戳从各数据源取同一个时间窗口。
通用日志解析器读取日志描述信息;当前训练脚本中的快捷 .bin 解析路径则固定了消息 ID 和结构。如果更换了日志格式,需要同步检查解析规则,避免仍按旧结构解释新数据。
如何把连续信号处理成 292 维输入?
用时间窗口定义一个样本
项目取 500 ms 为一个窗口,每次向前移动 100 ms。例如:
样本 A:读取 [1000, 1500) ms 内的各组数据样本 B:读取 [1100, 1600) ms 内的各组数据样本 C:读取 [1200, 1700) ms 内的各组数据
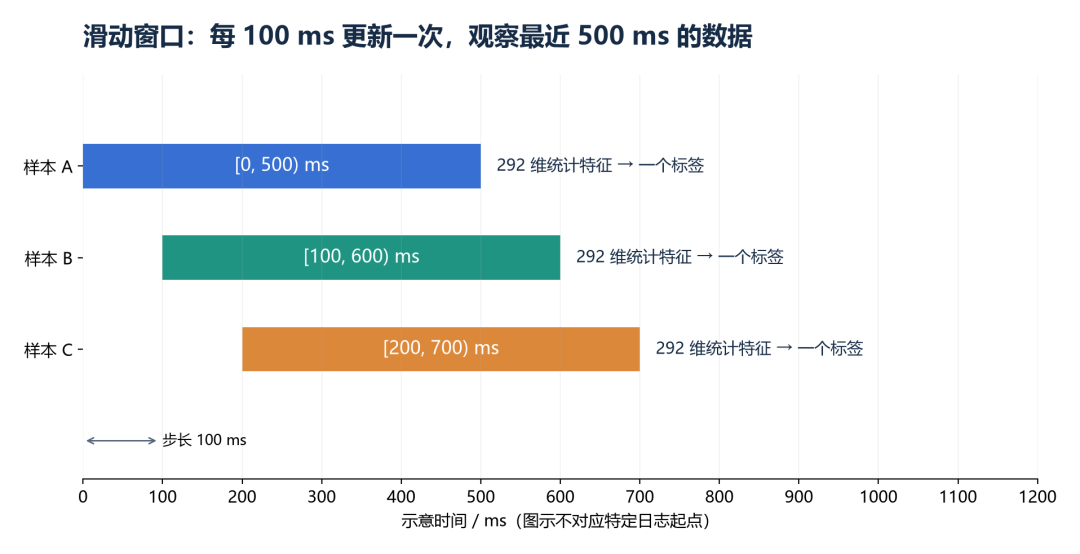
数据处理顺序为:解析消息、按时间戳排序、估计故障起点、生成窗口、筛选窗口标签,再分别对控制、INS、IMU、Pilot 数据计算特征。统计时忽略无效数值;缺少关键控制、INS 或 IMU 数据的窗口会被跳过。
以故障发生时间 fault_start_ms 为分界,当前标签规则可直接写成:
deflabel_window(start_ms, end_ms, fault_start_ms, fault_label): ifend_ms <= fault_start_ms - 500: return"normal" if start_ms >= fault_start_ms: returnfault_label returnNone # 故障前保护区及跨越边界的窗口不用于训练
新数据使用目录指定故障类别;旧数据根据各电机末段 PWM 相对前段基线的增量推断类别。故障起点来自规则估计,需要结合采集记录核对 run_label_summary.csv,特别是 label_source、故障起点和 PWM 证据。
一个信号提取九个统计量
每路信号在一个窗口内提取 count、mean、std、min、max、rms、abs_max、last、delta。其中标准差按总体方差计算,delta 是最后值减去第一个值。对应的 NumPy 表达如下,完整逻辑位于 build_motor_fault_dataset.py:
import numpy as np
def window_stats(values): x = np.asarray(values, dtype=np.float64) x = x[np.isfinite(x)] if x.size ==0: return np.zeros(9) return np.array([ x.size, x.mean(), x.std(ddof=0), x.min(), x.max(), np.sqrt(np.mean(x * x)), np.max(np.abs(x)), x[-1], x[-1] - x[0], ])
为了描述四路电机输出的不平衡,脚本还计算“最大 PWM 减最小 PWM”“每路 PWM 减其余三路均值”,以及每路 PWM 达到高位阈值的样本占比。292 维的组成如下:
特征组 |
计算方式 |
维数 |
四路 PWM 基础统计 |
4 × 9 |
36 |
四路 PWM 最大差值统计 |
1 × 9 |
9 |
每路相对其他三路的差值与高位占比 |
4 × (9 + 1) |
40 |
INS:3 路姿态角与 10 路运动状态 |
13 × 9 |
117 |
IMU:3 路角速度与 3 路加速度 |
6 × 9 |
54 |
Pilot:4 路操作输入 |
4 × 9 |
36 |
合计 |
- |
292 |
INS 的 phi/theta/psi 在提取前从弧度转换为度。特征列顺序由 metadata.json 的 feature_columns 固定,训练与部署都要使用同一顺序。
下面摘取训练 CSV 中一条实际样本的部分字段,展示原始信号如何变成一行数字:
window_start_ms = 60002window_end_ms = 60502label = motor1_faultcontrol_actuator_cmd_0_count = 5control_actuator_cmd_0_mean = 1853.2control_actuator_cmd_0_std = 93.6control_actuator_cmd_0_min = 1666.0control_actuator_cmd_0_max = 1900.0control_actuator_cmd_0_rms = 1855.5622control_actuator_cmd_0_last = 1900.0control_actuator_cmd_0_delta = 234.0...其余特征依 feature_columns 排列,总计 292 维
运行数据集构建脚本
使用当前目录结构中的日志生成五分类均衡数据集:
python scripts/build_motor_fault_dataset.py--modeinfer-bin--balance-labels--window-ms500--step-ms100--output-dirtraining_dataset_multiclass_balanced
结果目录包含:
training_dataset_multiclass_balanced/├── train_features.csv # 特征、窗口信息及标签├── test_features.csv├── metadata.json # 特征顺序、标签映射、样本统计└── run_label_summary.csv # 每条日志的标签来源和故障起点
现有记录中的 123 条末端异常日志共生成 19,198 个窗口。按类别下采样后,训练文件包含 2,390 条,测试文件包含 860 条,每类测试样本各 172 条。label、label_id、flight_id 和时间戳属于标签或辅助信息,不能一起送进模型。
怎样训练模型,训练得到什么?
先按同一个顺序取特征,再标准化
训练脚本从 feature_columns 取出输入,计算训练数据的均值与标准差,再将同一套参数用于测试数据:
feature_columns = metadata["feature_columns"]x_train = train_df[feature_columns].to_numpy(dtype="float32")x_test = test_df[feature_columns].to_numpy(dtype="float32")
mean = x_train.mean(axis=0)std = x_train.std(axis=0)std[std < 1e-6] = 1.0x_train = (x_train - mean) / stdx_test = (x_test - mean) / std
训练输入形状为 [样本数, 292],标签是 0~4 的整数:0=normal,1~4=motor1_fault~motor4_fault。标准化参数保存为 feature_mean.npy 与 feature_std.npy,后面转换和板端推理继续使用这一批参数。
定义 MLP 并训练
当前 train_motor_fault_mlp.py 的网络主体如下:
importtensorflowastf
model = tf.keras.Sequential([ tf.keras.layers.Input(shape=(292,), name="features"), tf.keras.layers.Dense(64, activation="relu", name="dense_64"), tf.keras.layers.Dropout(0.2), tf.keras.layers.Dense(32, activation="relu", name="dense_32"), tf.keras.layers.Dense(5, activation="softmax", name="class_probs"),], name="motor_fault_tiny_mlp")
最后一层使用 Softmax 输出五类得分。标签为 0~4 的整数,因此损失函数使用 sparse_categorical_crossentropy,分类时取最大值所在的下标。
下面是训练循环的核心逻辑摘录,完整脚本还包括数据加载、验证、早停、报告和模型导出:
model.compile( optimizer=tf.keras.optimizers.Adam(learning_rate=0.001), loss="sparse_categorical_crossentropy", metrics=["accuracy"],)early_stop = tf.keras.callbacks.EarlyStopping( monitor="val_accuracy", patience=20, restore_best_weights=True,)history = model.fit( fit_x, fit_y, validation_data=(val_x, val_y), epochs=200, batch_size=16, callbacks=[early_stop], verbose=2,)
实际运行直接调用已有脚本。以下命令将新产物放到一个明确的目录,后续步骤沿用这个目录:
pythonscripts/train_motor_fault_mlp.py --dataset-dir training_dataset_multiclass_balanced --output-dir model_training/mlp_article --epochs200--batch-size16--learning-rate0.001--validation-split0.2--patience20--seed42
脚本从训练文件中分出验证样本,每轮评估验证准确率,保留表现最好的权重;连续 20 轮没有提升就停止。现有保存批次的样本分配为:拟合 1,910 条、验证 480 条、测试 860 条。
这张图来自仓库已有的 mlp_20260622_144022 记录:第 36 轮验证准确率最好,第 56 轮早停。重新运行时以新的实际输出为准。
训练完成后,输出目录会出现:
model_training/mlp_article/├── motor_fault_mlp.keras # Keras 原始模型├── motor_fault_mlp_float32.tflite# 浮点 TFLite├── motor_fault_mlp_int8.tflite # 本文用于部署的 INT8 模型├── feature_mean.npy├── feature_std.npy├── preprocess.joblib # 特征顺序、均值、标准差、标签├── training_history.csv├── classification_report.txt├── confusion_matrix.png├── test_predictions.csv└── summary.json
训练脚本如何导出 INT8 TFLite?
脚本先保存 Keras 模型,再使用 TensorFlow Lite Converter 导出浮点和 INT8 两种版本。本文使用 motor_fault_mlp_int8.tflite。INT8 转换的核心代码如下:
def representative_dataset(): for row in x_train.astype("float32"): yield [row.reshape(1,292)] # 已标准化的训练特征
converter = tf.lite.TFLiteConverter.from_keras_model(model)converter.optimizations = [tf.lite.Optimize.DEFAULT]converter.representative_dataset = representative_datasetconverter.target_spec.supported_ops = [tf.lite.OpsSet.TFLITE_BUILTINS_INT8]converter.inference_input_type = tf.int8converter.inference_output_type = tf.int8withopen("motor_fault_mlp_int8.tflite","wb") as f: f.write(converter.convert())
代表性数据用于确定量化范围,必须与训练输入具有相同的列顺序和标准化参数。正常运行完整训练脚本时,上述量化和导出会自动完成。
量化后,脚本用 TFLite Interpreter 逐条测试。INT8 输入遵循 q = round(x / scale + zero_point),输出反量化遵循 x = (q - zero_point) * scale。以下为单样本推理的运行示例,x 表示已经标准化、形状为 [1, 292] 的输入:
interpreter = tf.lite.Interpreter(model_path="motor_fault_mlp_int8.tflite")interpreter.allocate_tensors()inp = interpreter.get_input_details()[0]out = interpreter.get_output_details()[0]in_scale, in_zero = inp["quantization"]q = np.clip(np.round(x / in_scale + in_zero), -128, 127).astype(np.int8)interpreter.set_tensor(inp["index"], q.reshape(inp["shape"]))interpreter.invoke()out_scale, out_zero = out["quantization"]scores = (interpreter.get_tensor(out["index"]).astype(np.float32) - out_zero) * out_scalepredicted_class = int(np.argmax(scores))
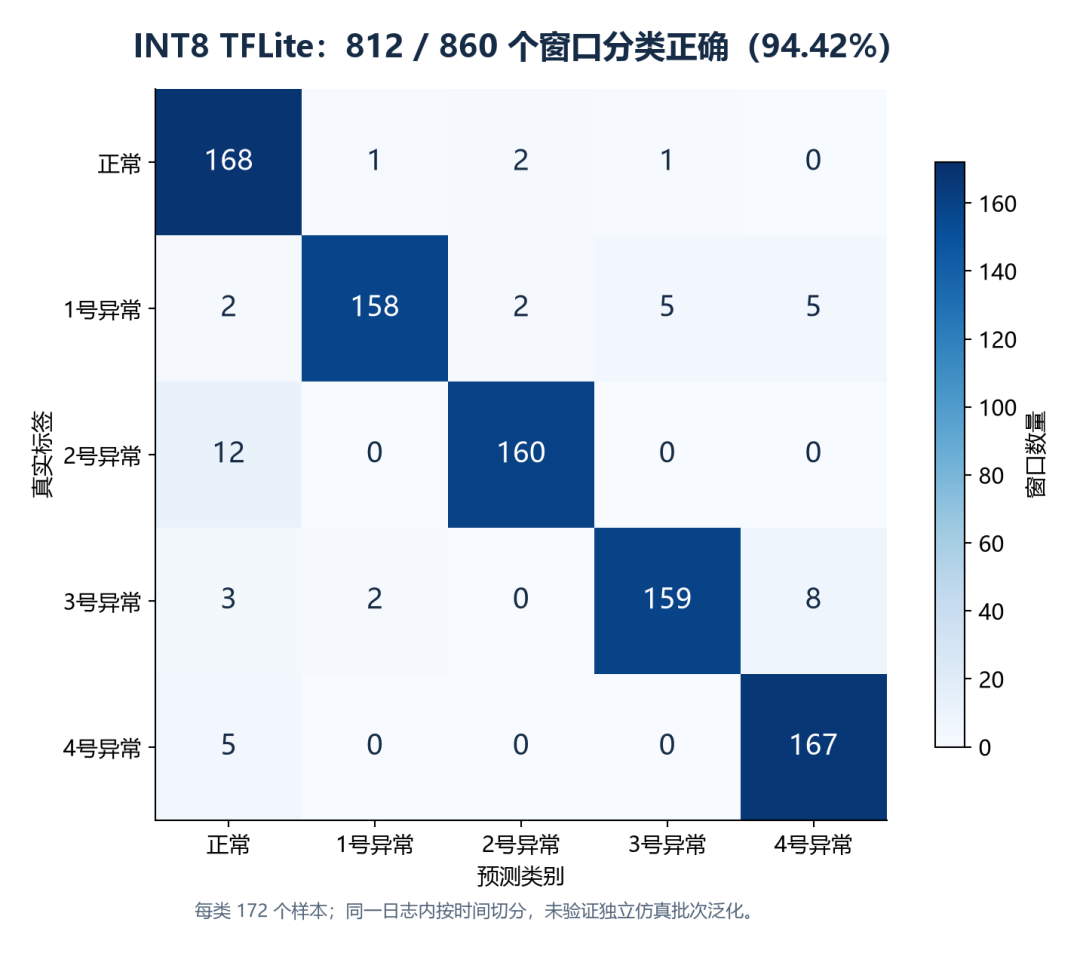
保存批次的离线测试 |
正确窗口数 / 总数 |
准确率 |
Keras 原始模型 |
824 / 860 |
95.81% |
motor_fault_mlp_int8.tflite |
812 / 860 |
94.42% |
图中使用 test_predictions.csv 的 int8_pred_label 重新统计混淆矩阵。量化后的结果与浮点模型有差异,部署模型的离线精度应引用 INT8 这一行。
这里的测试集是在每条日志、每种标签内部按时间划分的,相邻窗口还可能共享原始数据。因此,这个数字用于说明当前离线结果;评估跨场景效果时,应另留整条采集日志或独立仿真批次作为测试集。
用 DEEPCRAFT Model Converter 将 TFLite 转成 C 代码
前面完成的是Keras → INT8 TFLite。现在选择已确定的 motor_fault_mlp_int8.tflite,通过DEEPCRAFT Model Converter生成 EDGI-X M55/U55 目标使用的模型代码。下面的参数来自工程保存的转换记录与固件实际集成的头文件。
校准文件只包含模型实际接收的 292 列,而且已经使用同一训练批次的参数标准化。原始 PWM、标签列、时间戳、目录名都不能混进去。
生成可导入的校准文件和预处理代码
本教程附带 docs/article_code/prepare_conversion.py。训练完成后运行:
python docs/article_code/prepare_conversion.py --run-dir model_training/mlp_article --output-dir model_training/mlp_article/deploy
如果先复用仓库现有训练产物,则执行:
python docs/article_code/prepare_conversion.py --run-dir model_training/mlp_20260622_144022 --output-dir model_training/mlp_20260622_144022/deploy
两条命令选择一条,与要转换的模型批次保持一致。工具核心计算如下:
mean = np.load(run_dir /"feature_mean.npy")std = np.load(run_dir /"feature_std.npy")x = train_df[feature_columns].to_numpy(dtype="float32")x_calibration = ((x - mean) / std).astype("float32")
# 无表头、无标签:每行一个样本,每行 292 个数np.savetxt("representative_features_standardized.csv", x_calibration, delimiter=",", fmt="%.9g")
配套脚本默认选择同一目录下的 motor_fault_mlp_int8.tflite,检查 TFLite 文件标识,并生成标准化校准 CSV、标准化测试 CSV、独立测试标签、预处理 C 文件和 conversion_inputs.json 参数清单。当前数据对应校准矩阵 (2390, 292)、测试矩阵 (860, 292)。参数清单用于核对输入,不是可直接执行的转换工程。
motor_fault_preprocess.c 将该训练批次的 292 个均值、标准差固化为数组,板端执行与训练相同的公式:
for(unsignedi =0; i < feature_count; ++i) { features[i] = (features[i] - mf_feature_mean[i]) / mf_feature_std[i];}
在 DEEPCRAFT Model Converter 中配置
在 DEEPCRAFT Model Converter 中导入 motor_fault_mlp_int8.tflite,确认单样本输入 [1, 292]、输出五类,并选择对应的 PSoC Edge M55/U55 目标。下表中的目标与优化参数来自保存的 codegen/temp/ml_coretools_config.json,C API 来自当前固件的 model.h。仓库某个旧 .byom 文件仍指向其他模型,不能直接拿来作为当前 TFLite 的转换工程。
配置项 |
本项目的输入或选择 |
模型文件 |
motor_fault_mlp_int8.tflite |
输入形状 |
单样本张量[1, 292],生成 API 输入为 292 个数 |
目标平台 |
后端配置为PSE84_M55_U55 |
目标量化方案 |
int8x8,输入模型本身已是 INT8 |
U55 系统配置 |
PSE8x_U55_400MHz_SOCMEM_300MHz_QUAD_XIP |
内存模式 / 优化方向 |
Shared_Sram/Performance |
校准数据 |
representative_features_standardized.csv |
校准列范围 |
从第 0 列开始,共 292 列,无表头和标签 |
校准样本数 |
准备文件共 2,390 行;保存的转换配置最多使用 1,000 个,选择子集时需覆盖各类 |
C 接口 |
float32Api = true,接口前缀IMAI_ |
输出名称、目录 |
model,输出到该批次deploy/codegen |
运行模型转换与代码生成后,查看输出目录,至少应包含 model.c、model.h 和转换报告。模型内部使用 INT8 时,外部 API 仍可接收浮点特征,前提是启用了 float32 API。
核对生成头文件:
#defineIMAI_DATA_IN_COUNT (292)#defineIMAI_DATA_OUT_COUNT (5)
intIMAI_init(void);intIMAI_compute(constfloat *data_in,float*data_out);
还要检查报告中的算子支持、模型与工作区内存、运行库版本要求。现有生成代码要求 ml-middleware 3.2.0、ml-tflite-micro 3.2.0 等配套库。生成文件成功以后,继续使用同一测试输入比较转换前后的类别与数值误差。保存的转换配置没有使用真实测试集给出完整精度验证结果,不能把“文件已生成”当成精度验证已通过。
当前报告记录模型内存 24,848 字节、工作区 16,384 字节;这些不是整个固件的总内存。报告里的 NPU 周期数据也不能替代板端计时。本次还核对了代码来源:固件 m55/applications/ai_model/model.c 和 model.h,分别与 mlp_20260622_144022/codegen.zip 内的同名文件逐字节一致。
怎么放进 FMT 工程,怎么编译和烧录?
模型与业务代码放在哪里
当前 M55 工程已经划分好职责:
target/infineon/edge-e83/m55/applications/├── motor_fault_app.c # 订阅数据、维护窗口、定时触发├── motor_fault_features.c # 从窗口计算 292 维特征├── motor_fault_features.h # 采样率、窗口长度、维度常量├── motor_fault_preprocess.c # 当前模型的标准化参数├── motor_fault_model.c # 初始化、模型调用、分类、异常提示├── motor_fault_model.h├── SConscript└── ai_model/ ├── model.c # 转换器生成 ├── model.h └── SConscript
先保存旧版本,再成套替换模型与预处理。 以本次训练目录 mlp_article 为例,在 FMT无人机电机训练 目录执行下面的 PowerShell;这些复制命令应在转换完成且文件检查通过后运行:
$deployDir=Resolve-Path'./model_training/mlp_article/deploy'$appDir=Resolve-Path'../FMT-Firmware/target/infineon/edge-e83/m55/applications'
Get-Item"$deployDir/codegen/model.c","$deployDir/codegen/model.h","$deployDir/motor_fault_preprocess.c"
$backupDir=New-Item-ItemTypeDirectory-Path(Join-Path$deployDir('firmware_backup_'+ (Get-Date-Format'yyyyMMdd_HHmmss')))Copy-Item-LiteralPath"$appDir/ai_model"-Destination$backupDir.FullName-RecurseCopy-Item-LiteralPath"$appDir/motor_fault_preprocess.c"-Destination$backupDir.FullName
Copy-Item-LiteralPath"$deployDir/codegen/model.c"-Destination"$appDir/ai_model/model.c"Copy-Item-LiteralPath"$deployDir/codegen/model.h"-Destination"$appDir/ai_model/model.h"Copy-Item-LiteralPath"$deployDir/motor_fault_preprocess.c"-Destination"$appDir/motor_fault_preprocess.c"
类别映射仍为“正常、1、2、3、4 号电机异常”。若新数据或新模型改变了输出顺序,还要同步修改 motor_fault_model.c 中的类别名称与编号。
applications/SConscript 检测模型文件与依赖头文件,满足条件才定义 MF_ENABLE_AI_MODEL;ai_model/SConscript 再把生成的 model.c 纳入构建,并设置 TFLM、U55 等编译宏。因此需要留意 MotorFaultAIModel disabled, missing: ... 这样的构建提示:整个固件编译成功,并不自动表示 AI 模型已启用。
本工程需要先校对的输入差异
模型文件替换后,输入数据的定义也要一致。当前源码里有两处具体差异值得在这里处理:
项目 |
离线训练 |
当前板端实现 |
处理方法 |
PWM 高位占比 |
PWM >= 1850 |
默认阈值 1250,使用> |
若沿用训练数据定义,板端阈值改为 1850,比较符同步为>= |
窗口取样 |
各消息按自己的记录时间取样 |
每 10 ms 读取各话题最新值 |
统一取样定义后,逐项对比特征;必要时按板端取样方式重建训练数据 |
PWM 对齐修改对应 motor_fault_app.c 与 motor_fault_features.c:
#defineMOTOR_FAULT_PWM_HIGH_DEFAULT 1850.0f
/* build_pwm_derived() 中的高位统计 */if(cmd[motor] >= pwm_high_threshold) { high_count[motor]++;}
取样差异会影响 count,也可能影响均值、方差等量。例如样例日志 500 ms 内有约 5 条控制记录、250 条 IMU 记录,而板端统一缓冲 50 帧。当前旧预处理代码对 count 另做了人工对齐;配套脚本生成的新预处理只忠实执行训练公式,没有延续这种替换。因此,新模型的固定输入验证可以先做,在线精度需在统一取样定义后验证。这些是当前工程的实际适配项,不能仅靠复制模型文件省略。
编译 M55 固件
从 FMT无人机电机训练 进入板级目录。将工具链路径改为本机实际安装位置;这里使用项目 rtconfig.py 中出现的路径作为示例:
Set-Location ../FMT-Firmware/target/infineon/edge-e83/m55$env:RTT_EXEC_PATH ='D:\ProgramFiles\RT-ThreadStudio\repo\Extract\ToolChain_Support_Packages\ARM\GNU_Tools_for_ARM_Embedded_Processors\13.3\bin'$env:RTT_EXEC_PATH_OVERRIDE =$env:RTT_EXEC_PATH&"$env:RTT_EXEC_PATH/arm-none-eabi-gcc.exe"--versionscons -j8
scons 需在当前终端可用。构建完成后,检查三个主要产物:
build/fmt_e83-m55.elf # 调试符号与可执行映像build/fmt_e83-m55.hex # 工程烧录配置使用的文件build/fmt_e83-m55.map # 查看模型、缓冲区和任务栈的内存布局
使用工程自带的下载脚本
在指定固件目录中找到了 tools/m55_program.ps1。它默认读取 m55/build/fmt_e83-m55.hex,调用 OpenOCD-Infineon/bin/openocd.exe,加载 interface/cmsis-dap.cfg 和 target/infineon/pse84xgxs2.cfg,执行写入、校验、复位。
因此,按当前仓库能确认的入口,完整操作分为 SCons 构建 和 下载脚本写入 两步。前面的 scons -j8 在 edge-e83/m55 执行;没有找到 scons --download、scons --flash 等下载目标,不能把这样的参数写进教程。
先核对脚本中的 OpenOCD 搜索路径。当前磁盘存在的是 tools/OpenOCD-Infineon/scripts,脚本保存的路径却多了一层 openocd。使用这个下载入口前,应将 m55_program.ps1 中对应一行改为:
$openocd_scripts_dir="$tools_dir_path/scripts"
然后从当前 edge-e83/m55 目录调用脚本:
powershell -File ../tools/m55_program.ps1
脚本实际执行的下载指令为:
init;resethalt; program verifyresetexit;
这里需要连接该脚本支持的 CMSIS-DAP 调试接口,并保留原有可启动 FMT 的 M33/启动链。本文依据脚本给出下载入口,本次未连接硬件执行烧录;下载工具的校验结果和复位后的运行状态应在板端确认。
上电后模型怎么跑,如何看到推理结果?
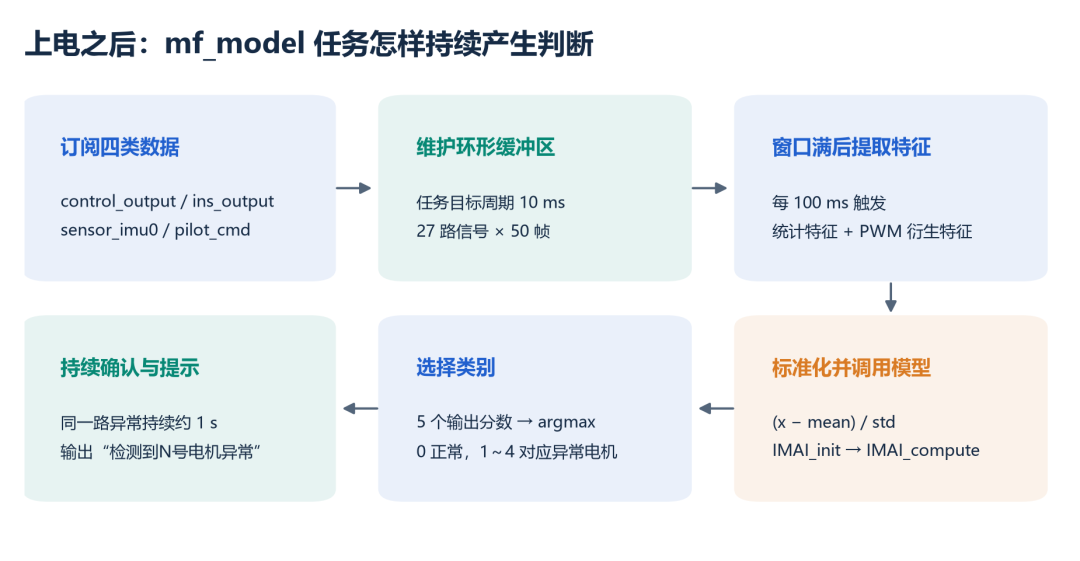
FMT 自动启动采集任务
motor_fault_app.c 中注册了一个自动启动任务,核心配置为:
TASK_EXPORT __fmt_motor_fault_task_desc = { .name ="mf_model", .init = task_motor_fault_init, .entry = task_motor_fault_entry, .priority =24, .auto_start =true, .stack_size =8192,};
初始化时订阅 control_output、ins_output、sensor_imu0、pilot_cmd。任务按目标 100 Hz 读取最新值,每帧包含 27 路信号,放进 50 帧的环形缓冲区。缓冲区满后,按目标 100 ms 间隔提取特征并调用模型。
下面摘录调用顺序,数组与函数定义已在工程中:
mf_copy_window_ordered(mf_ordered_window);mf_feature_count = motor_fault_extract_features( mf_ordered_window, MOTOR_FAULT_WINDOW_SIZE, mf_pwm_high_threshold, mf_input, MOTOR_FAULT_FEATURE_COUNT);
if (mf_feature_count == MOTOR_FAULT_FEATURE_COUNT) { motor_fault_preprocess_features(mf_input, mf_feature_count); motor_fault_on_features(mf_input, mf_feature_count, now_ms);}
模型层在首次收到完整特征时调用 IMAI_init(),初始化成功后复用实例,每次通过 IMAI_compute() 得到五个输出分数:
/* 简化展示:实际工程还保存状态并检查返回码 */if(!initialized) { if(IMAI_init() !=0) { return; } initialized =1;}
if(IMAI_compute(features, output) ==0) { intbest =0; for(inti =1; i < 5; ++i) { if (output[i] > output[best]) best = i; } /* best == 0 为正常;1~4 对应异常电机编号 */}
本文 Keras 模型包含 Softmax,量化部署后得到五类输出分数,argmax 用于选出预测类别。直接调用 INT8 TFLite Interpreter 时,需要按模型的 scale/zero-point 量化输入;现有生成 C API 接受 float 输入,调用方应送入标准化浮点特征,不再额外手工转为 INT8。
在串口中逐层检查
固件运行后,依次执行:
tasklistmf_statusmf_dump16mf_model_status
mf_status 查看采集任务是否运行,窗口是否达到 50/50,feature_count 是否达到 292。mf_dump 16 打印当前预处理后输入的前 16 项,完整输入可用 mf_dump 292 查看。mf_model_status 检查模型是否启用、初始化是否成功,以及最近一次分类。
下面是输出格式示意,并非本次板端实测记录:
motor fault collector: runningsamples: 50/50 write_index: <当前下标> feature_count:292
motor fault model: enabledinitialized:1 init_result:0 last_compute_result:0last_timestamp_ms: <最近一次时间戳> class:1 motor1_faultout[0]= <类别0分数> ...out[4]= <类别4分数>
代码会在同一路电机异常判断持续约 1 秒后输出对应提示,例如 检测到1号电机异常。如果恢复正常或切换到其他异常电机,持续确认状态会重置。这个 1 秒是提示确认逻辑;100 ms 是目标调用间隔,500 ms 是目标窗口长度,都不等于已经测得的模型执行时间或端到端检测延迟。
采集任务已经自动启动,无需再用 mf_start 启动。当前 mf_start、mf_stop 只是打印说明;需要临时暂停、恢复,应使用任务管理命令:
tasksuspendmf_modeltask resume mf_model
用状态信息定位问题
现象 |
优先检查 |
终端没有 FMT Shell |
控制台是否为 serial4、波特率是否被 sysconfig.toml 改写;USB 是否为 MAVLink 通道 |
mlog start没有有效日志 |
SD 卡挂载、日志会话目录、logger 任务状态 |
samples不增长 |
mf_model是否运行,话题是否可订阅 |
有 292 维特征,但模型显示disabled |
MF_ENABLE_AI_MODEL是否定义,生成文件及依赖头文件是否完整 |
初始化或计算返回非零 |
转换器要求的运行库、内存布局、目标配置和输入维度 |
能计算,但分类持续异常 |
同批标准化参数、标签顺序、PWM 阈值、采样密度与缺失数据 |
最后用两种输入分别验证:先把 PC 的固定标准化测试向量送给板端模型,检查转换与模型调用;再接入真实话题,检查实时特征是否与训练定义一致。记录各类别结果、误报漏报及实际耗时后,才能评价这一版模型在 EDGI-X 上的在线表现。
配套文件
article_assets/01_workflow.png~06_runtime.png:流程、真实数据、窗口、训练曲线、混淆矩阵和运行图。
article_code/prepare_conversion.py:为指定 TFLite 批次生成校准数据、预处理 C 文件和转换输入清单。
article_code/build_article_assets.py:从项目已有数据重建插图和图文 HTML。
edgi_x_motor_fault_article_notes.md:来源、版本关系和核对记录。
正文中的命令来自当前项目或配套脚本;图表取自项目保存的数据。此次制作教程核对了源码并生成配套数据,没有重新训练、执行模型转换或烧录开发板。